
Resumo deste artigo
- Ser rastreado por um buscador e ser citado por um assistente de IA são coisas diferentes. O modelo extrai trechos autossuficientes e atribui a uma entidade identificável, então página sem hierarquia clara e sem marcação de autor e organização é lida e descartada.
- Publicar mais artigos não corrige ausência de citação quando a barreira é arquitetura. Volume sem estrutura aumenta custo editorial sem aumentar a chance de a marca aparecer na resposta.
- A primeira frase de cada seção decide se o trecho é citável. Se ela depende do parágrafo anterior para fazer sentido, o modelo não consegue extrair nada aproveitável.
- Diagnóstico vem antes de reforma. Saber quais marcas aparecem no lugar da sua e qual barreira técnica bloqueia a citação custa menos e orienta melhor o investimento do que refazer o site por intuição.
- WordPress raramente precisa ser substituído por causa de GEO. A maior parte da correção estrutural acontece em schema, hierarquia de headings e renderização, sem trocar o CMS.
Você investiu em conteúdo, aliás, vem investindo há um bom tempo. Publicou com constância, contratou redação, revisou pauta, artigo com boas imagens, comunicação clara e objetiva. Ainda assim, quando alguém da sua equipe pergunta ao ChatGPT ou ao Gemini sobre o seu mercado, aparecem três concorrentes e nenhuma menção à sua empresa. A conclusão intuitiva é que falta volume, e aí entra a decisão cara: dobrar a produção de artigos.
Na maioria dos casos esse diagnóstico está errado, porque o conteúdo existe, é bom e está indexado. O que falta é a estrutura de site para IA, ou seja, a camada que permite a um modelo de linguagem identificar o que a página afirma, quem afirma e em que contexto. Sem isso, o texto é rastreado e descartado antes de virar resposta.
Este artigo explica a diferença entre ser rastreado e ser citável, mostra quais sinais estruturais bloqueiam a citação, por que mais conteúdo não resolve e o que dá para corrigir no site que você já tem. É um raciocínio que segue a mesma lógica do método onion, a conexão entre marketing, produto e growth operando juntos em vez de isolados: conteúdo sem arquitetura é marketing isolado, e marketing isolado vira desperdício.
A diferença entre ser rastreado e ser citável por assistentes de IA
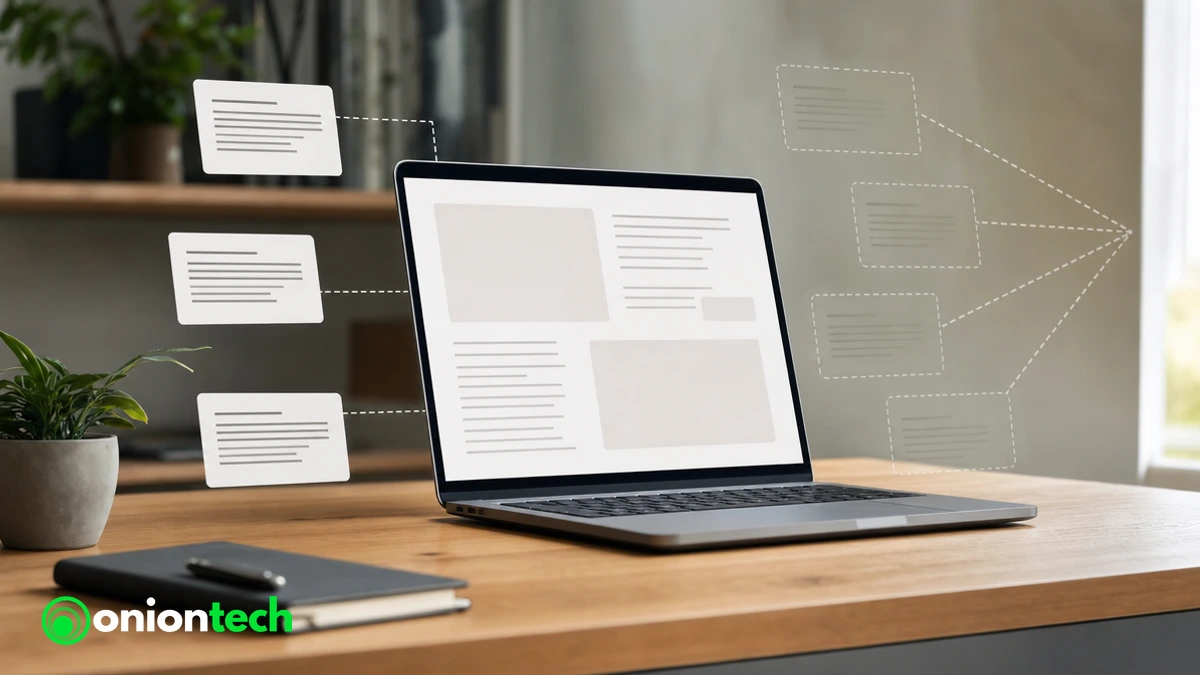
Ser rastreado significa que o crawler acessou a URL, leu o HTML e guardou o conteúdo. Ser citável significa que um modelo consegue extrair uma afirmação completa da sua página, entender de quem ela é e reproduzi-la como resposta a uma pergunta. São dois estágios distintos, e quase todo site de PME passa no primeiro e falha no segundo.
A diferença está basicamente em como o modelo processa a página. Um leitor humano chega no seu artigo, lê o parágrafo anterior, entende o contexto e segue em frente. Já um sistema de recuperação não trabalha assim.
Ele quebra a página em trechos, pontua cada trecho pela capacidade de responder sozinho a uma pergunta e descarta o que depende de contexto externo. Por exemplo, um parágrafo que começa com "além disso, essa abordagem permite" é tecnicamente perfeito em português e completamente inútil como citação, porque "essa abordagem" não significa nada fora da página.
Some a isso a questão da atribuição, porque para citar uma fonte o assistente precisa saber quem é a fonte. Se o site não declara organização, autor e data de publicação de forma legível por máquina, o modelo fica com um texto órfão nas mãos.
Diante da escolha entre um trecho órfão e um trecho equivalente assinado por uma entidade identificável, ele vai usar o segundo. Não se trata de preferência editorial, e sim de redução de risco do próprio sistema.
Por isso o volume não compensa a falta de estrutura: vinte artigos órfãos continuam órfãos. O trabalho que muda o jogo é tornar cada página legível em três níveis, ou seja, o que ela afirma, quem afirma e como ela se conecta às outras páginas do mesmo assunto. Essa lógica é a mesma que sustenta o AEO na prática, a otimização para respostas em vez de otimização para cliques.
1. Hierarquia de headings quebrada
A hierarquia de títulos é o esqueleto que informa ao modelo onde começa e termina cada assunto. Quando a página usa H1 em duas chamadas diferentes, pula de H2 para H4 porque o H3 ficava feio no tema, ou usa texto em negrito no lugar de subtítulo real, o sistema não consegue delimitar os blocos. Tudo vira um único bloco longo, e bloco longo não é extraído.
O erro mais comum em sites de PME costuma ser estético. Alguém decidiu que o H2 do tema padrão estava muito grande, trocou por um parágrafo em negrito maior e o problema ficou invisível para o time: visualmente idêntico, estruturalmente inexistente.
Outro padrão frequente é usar heading em elementos de layout, como rodapé, banner lateral ou chamada de newsletter, o que faz o modelo interpretar ruído como tópico principal da página. A correção é barata e normalmente cabe numa revisão de template, sem tocar no texto publicado.
2. Ausência de Schema Article e Organization
Schema markup é o bloco de dados que diz, em linguagem de máquina, o que aquela página é. Segundo a documentação do Schema.org e as diretrizes de dados estruturados do Google Search Central, um Article completo carrega headline, datePublished, dateModified, author e publisher.
Sem esses campos, o modelo precisa adivinhar autoria e atualidade, e adivinhar significa, quase sempre, preferir outra fonte.
Muitos sites têm schema parcial: o plugin gerou alguma coisa, mas sem organização vinculada, sem autor real, sem data de modificação. O resultado é pior do que parece, porque um schema incompleto declara a entidade de forma ambígua. Também falta, quase sempre, o Schema Organization na home com name, url, logo e sameAs apontando para os perfis oficiais.
É esse schema que amarra todo o site a uma entidade única e reconhecível, então, sem ele, cada página acaba flutuando sozinha.
3. Conteúdo que só existe depois do Javascript
Se o texto principal da página só aparece após a execução de scripts, você está apostando que todo crawler vai renderizar a página inteira antes de ler. Alguns renderizam, outros não, e os que renderizam fazem isso com atraso e orçamento limitado.
Esse cenário é comum em páginas construídas com builders pesados, em abas que carregam conteúdo por clique e em seções em acordeão que só injetam o texto quando alguém abre.
O teste é simples e qualquer pessoa do time consegue fazer: desative o JavaScript no navegador e recarregue a página. O que sobrar na tela é, aproximadamente, o que o sistema tem garantido para trabalhar. Se sobrou o menu e um rodapé, o problema não é de conteúdo.
Vale repetir o teste nas páginas que mais importam comercialmente, porque costuma ser justamente nelas que o time caprichou no efeito visual.
4. Páginas soltas, sem cluster nem página de autor
Uma página isolada não constrói autoridade temática. Quando dez artigos sobre o mesmo assunto não se conectam entre si nem apontam para uma página principal, o modelo vê dez sinais fracos em vez de um sinal forte.
O mesmo vale para a autoria. Um site sem página de autor com biografia, credencial e histórico de publicações entrega conteúdo sem rosto, e para um sistema que precisa atribuir afirmações a alguém isso é um problema de confiança, não de estilo.
Autor identificável e organização declarada são o que transforma uma afirmação técnica em algo citável com segurança, e nenhuma dessas duas correções depende de escrever uma linha nova de conteúdo.
Por que publicar mais conteúdo não resolve o problema
Mais conteúdo multiplica o que já existe, inclusive os defeitos. Se o template atual produz páginas sem schema completo, sem hierarquia limpa e sem vínculo com uma pilar, cada novo artigo nasce com a mesma barreira. Você paga redação, revisão e publicação para gerar outro item que o modelo vai ler e ignorar.
Tem um raciocínio de custo que vale fazer antes de aprovar o próximo calendário editorial. Um artigo custa produção, publicação, imagem e revisão, e multiplicado por doze meses isso vira uma linha relevante no orçamento.
Agora compare com o custo de corrigir a estrutura uma vez: a correção vale para o acervo inteiro, incluindo tudo que já foi publicado nos últimos anos. É o mesmo tipo de decisão que todo gestor já tomou em mídia, quando descobriu que aumentar verba não conserta uma landing page que não converte.
Existe uma exceção legítima: se o seu site cobre mal o tema, se há perguntas óbvias do seu mercado sem nenhuma página correspondente, aí é falta conteúdo mesmo! Mas essa é uma hipótese que se verifica em pouco tempo, listando as dez perguntas que seus clientes mais fazem e checando se existe uma página dedicada a cada uma.
Quando as páginas existem e ninguém é citado, o problema possivelmente mudou de lugar. Vale também olhar para o outro lado do acervo, porque nem toda página precisa ser citável.
Material de fundo de funil, que existe para converter quem já conhece a marca, tem função diferente de conteúdo informacional, e essa distinção aparece com clareza na diferença entre copywriting e criação de conteúdo.
Misturar os dois objetivos na mesma página costuma prejudicar os dois.
O raciocínio central é o mesmo do Método Onion, a conexão de três camadas que trabalham juntas em vez de isoladas: produção editorial desconectada da arquitetura do site é exatamente o tipo de esforço que consome orçamento sem virar resultado previsível.
Como testar se sua marca é citada por IA antes de investir
Antes de contratar reforma, vale medir. O teste inicial você faz sozinho em uma tarde, e ele já separa dois cenários bem diferentes: marca ausente por falta de estrutura e marca ausente por falta de presença no mercado.
Monte uma lista de dez a quinze perguntas que um cliente seu faria sem saber que a sua empresa existe, e não use o nome da marca em nenhuma delas.
Depois rode essas perguntas em ChatGPT, Gemini e Perplexity, sempre em sessões sem histórico, anotando três coisas em cada resposta: se a sua marca aparece, quais marcas aparecem no lugar dela e quais fontes o assistente cita.
Essa terceira coluna costuma ser a mais reveladora. Se os assistentes citam consistentemente portais setoriais, diretórios e três concorrentes, você descobriu onde o modelo busca autoridade no seu nicho. E se esses concorrentes não produzem mais conteúdo que você, a diferença está na camada estrutural, não na editorial.
O teste manual tem limites conhecidos: a amostra é pequena, as respostas variam entre sessões e ele não aponta qual barreira técnica está bloqueando a citação. É aí que entra um diagnóstico estruturado.
O Onion AI Scan, nossa solução de auditoria de IA, mostra se a sua empresa é citada nas respostas de IA, quem aparece no lugar dela e o que impede a citação da sua marca, o que evita decidir reforma de site por intuição. Você pode inclusive fazer um teste gratuito na página do serviço, sem necessitar de nenhum cadastro ou pagamento.
Vale complementar com o que o próprio Google já entrega: o relatório de IA generativa no Google Search Console dá visibilidade sobre o comportamento das suas páginas nas superfícies com IA.
O que corrigir primeiro no site que você já tem
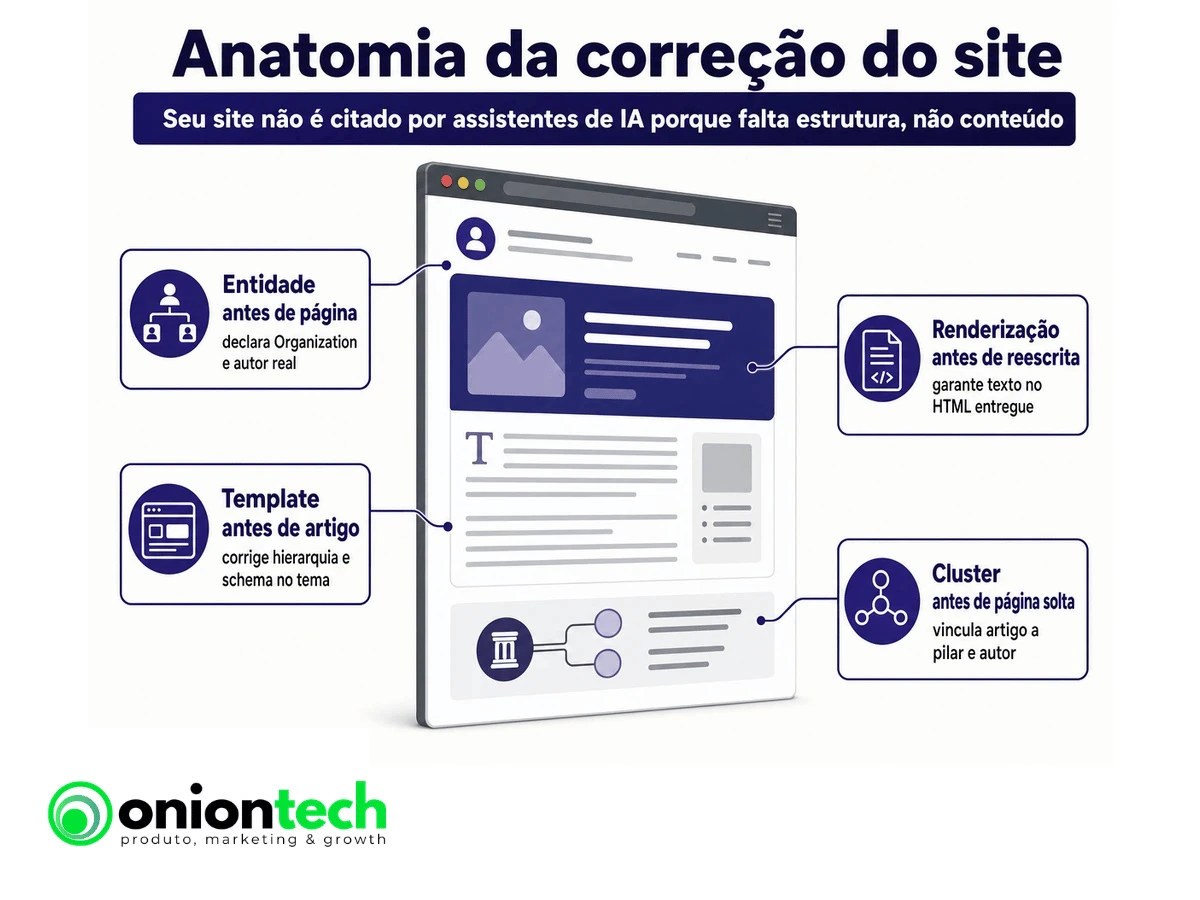
Quando o diagnóstico aponta estrutura, a sequência de correção importa, porque algumas mudanças acabam destravando várias outras. A ordem abaixo prioriza o que tem maior efeito sobre o acervo inteiro e menor risco de quebrar o que já funciona.
- Entidade antes de página: declare Organization na home com name, url, logo e sameAs, e crie páginas de autor reais com biografia e credencial. Isso dá sobrenome a todo conteúdo publicado.
- Template antes de artigo: corrija hierarquia de headings e schema Article no tema do site. Uma correção de template alcança centenas de URLs de uma vez.
- Renderização antes de reescrita: garanta que o texto principal exista no HTML entregue. Conteúdo que depende de clique ou script não entra na conta.
- Conexão antes de volume: organize os artigos existentes em clusters com página pilar e links internos coerentes antes de produzir material novo.
- Primeira frase de cada seção: revise os textos de maior potencial comercial para que o parágrafo de abertura responda sozinho, sem depender do anterior.
Essas frentes se dividem entre configuração técnica e revisão editorial. A parte de arquitetura de conteúdo, marcação e otimização para busca e para assistentes é o escopo de um trabalho de SEO, GEO e AEO, que trata busca tradicional e resposta generativa como a mesma operação em vez de projetos separados.
Vale lembrar o tamanho do terreno nessa decisão. O WordPress é o CMS de código aberto mais popular e utilizado em todo o mundo, presente em milhões de sites, o que significa que boa parte das correções estruturais de GEO já tem caminho conhecido, plugin maduro e documentação disponível. Trocar de CMS raramente é a resposta.
O que costuma resolver é uma reformulação do site em WordPress com a camada de dados estruturados, hierarquia e performance tratada desde o início, aproveitando o conteúdo que já existe.
Para fechar
Se a sua empresa publica com constância e mesmo assim não aparece nas respostas do ChatGPT, do Gemini ou do Perplexity, a hipótese mais provável não é falta de conteúdo, e sim a falta da camada que torna esse conteúdo legível, atribuível e conectado.
Hierarquia quebrada, schema incompleto, texto dependente de JavaScript e páginas sem cluster bloqueiam a citação, por melhor que seja a qualidade do texto.
O próximo passo prático é barato e rápido: rode o teste de prompts com as perguntas reais do seu mercado, anote quem aparece no seu lugar e desative o JavaScript nas três páginas que mais importam para a sua receita. Com esses dois dados em mãos, você já sabe se o investimento deve ir para produção editorial ou para arquitetura, e para de decidir no escuro.
Se a sua empresa tem urgência em transformar o crescimento em algo estruturado, previsível e escalável, a Onion Tech oferece uma assessoria completa que une Marketing, gestão de produtos digitais e Growth Marketing.
Perguntas frequentes
Quais sinais estruturais impedem a citação do seu site?
Os bloqueios mais comuns não são exóticos. Eles aparecem repetidos em sites bem construídos visualmente, com design aprovado e conteúdo revisado, porque ninguém olhou para a camada que o modelo lê. Vale tratá-los como critérios de diagnóstico, não como tarefas de engenharia: você precisa saber o que pedir, não escrever o código.
Quanto tempo leva para começar a aparecer em respostas de IA depois das correções?
Em geral, de 30 a 90 dias, dependendo da frequência com que seus conteúdos são recrawleados e da competitividade do tema. Correções estruturais não geram efeito imediato porque os sistemas precisam reprocessar as páginas. Temas com poucas fontes consolidadas tendem a responder mais rápido. Vale acompanhar mês a mês, sem esperar virada de chave em duas semanas.
Isso faz sentido para uma empresa B2B de nicho, com público pequeno?
Sim, e muitas vezes faz mais sentido do que em mercados amplos. Nichos têm menos fontes disputando a mesma resposta, então uma marca com estrutura correta ocupa espaço com menos esforço. O volume de buscas é menor, mas a intenção costuma ser mais qualificada. Em B2B, uma citação bem posicionada alcança exatamente quem decide a compra.
Preciso abandonar o SEO tradicional para investir nisso?
Não. As duas frentes compartilham a mesma base técnica: rastreabilidade, hierarquia limpa, velocidade e conteúdo relevante. O que muda é a camada adicional de atribuição e autossuficiência dos trechos.
Na prática, sites bem otimizados para busca partem na frente. Tratar como substituição é um erro caro, porque você perde tráfego orgânico já consolidado sem ganhar nada em troca. Quanto custa esse tipo de correção estrutural?
Qual o risco de mexer no schema e quebrar alguma coisa?
O risco é baixo e controlável, desde que a alteração seja validada antes de ir ao ar. Schema mal formatado não derruba o site nem remove páginas do índice, mas pode anular o ganho pretendido. Teste em ambiente de homologação, valide com as ferramentas oficiais de dados estruturados e publique por lote, acompanhando o comportamento nas primeiras semanas.
Leia Também
• Densidade de Keywords: como otimizar conteúdo para crescimento sem perder conversão
• Como a IA Generativa está redefinindo a criação de conteúdo